

Yapay Zekâ Altın Madalya Aldı Ama Gençler Zirvede Kaldı
Dünyanın en prestijli matematik yarışmalarından biri olan Uluslararası Matematik Olimpiyatı’nda (IMO), bu yıl ilk kez yapay zekâ modelleri altın madalya seviyesinde başarı elde etti. Ancak bu devrim niteliğindeki başarıya rağmen, Google ve OpenAI tarafından geliştirilen bu ileri düzey sistemler, hâlâ olağanüstü yetenekli lise öğrencilerinin gerisinde kaldı.
Matematikteki bu ilginç tablo, yapay zekânın ne kadar gelişmiş olursa olsun hâlâ insan mantığıyla yarışmakta zorlandığını bir kez daha gözler önüne serdi.
Rehber
Yapay Zekâ Neden Zorlanıyor?
Matematik, yapay zekâ sistemlerinin en büyük sınavlarından biri olmaya devam ediyor. Bunun nedeni, bu teknolojilerin çalışma prensibiyle doğrudan ilgili. Örneğin ChatGPT ya da Google Gemini gibi modeller, bir soruyu yanıtlamadan önce metni “token” adı verilen küçük parçalara ayırıyor ve ardından en olası cevap dizisini tahmin ediyor. Oysa insanlar bu tür soruları mantıksal düşünme, kavrama ve çıkarımsal akıl yürütmeyle çözüyor.
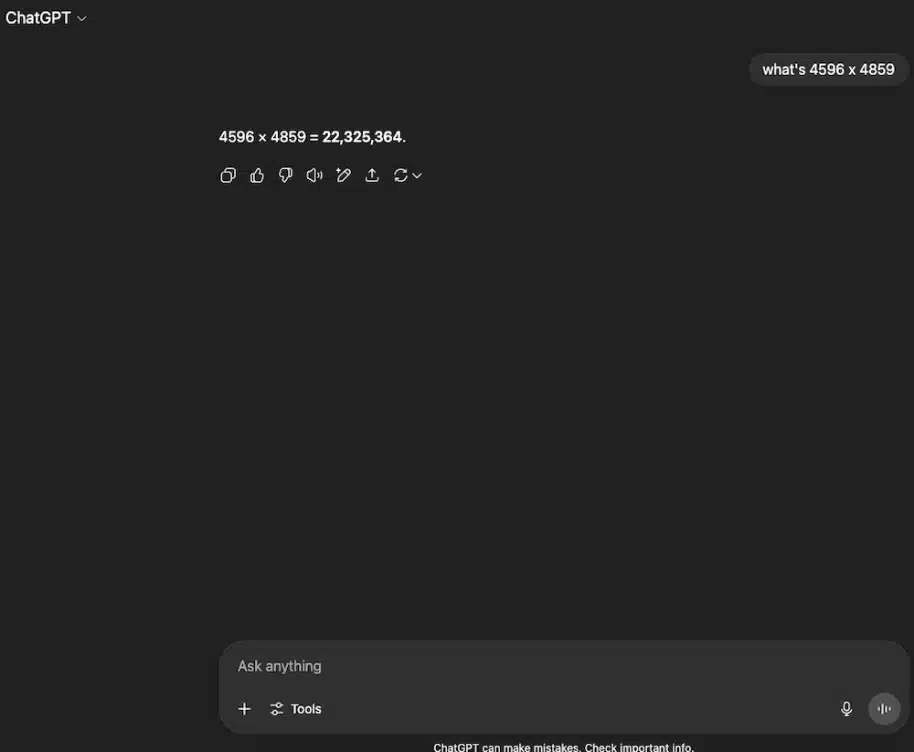
Matematik soruları genellikle sadece tek bir doğru cevaba sahiptir. Bir hesap makinesiyle 4596 × 4859 işleminin sonucu her zaman 22.331.964 olacaktır. Ancak bir yapay zekâ modeli, hâlâ 22.325.364 gibi hatalı bir yanıt verebiliyor. İşte bu fark, teknolojinin ne kadar gelişmiş olursa olsun insan zekâsına kıyasla hâlâ eksik olduğunu gösteriyor.
2025 IMO’da Neler Yaşandı?
1959’dan bu yana her yıl düzenlenen IMO, genç matematikçilerin yeteneklerini sergilediği en zorlu platformlardan biri. Bu yıl Avustralya’nın Queensland eyaletinde gerçekleştirilen 66. yarışmaya, 112 ülkeden 641 öğrenci katıldı. 15 Temmuz’da düzenlenen sınavda, katılımcılardan 4,5 saat içinde 6 zorlu soruyu çözmeleri istendi.
Bu yılın farkı, yarışmacılar arasında iki güçlü rakibin daha olmasıydı: Google ve OpenAI tarafından geliştirilen iki deneysel yapay zekâ modeli.
Her iki yapay zekâ da 6 sorudan 5’ini başarıyla çözdü ve 42 puan üzerinden 35 puan alarak altın madalya seviyesine ulaştı. Bu yıl bu başarıya ulaşan insan katılımcıların oranı sadece %10 civarındaydı.
Google’ın geçen yılki denemesinde ise model sadece dört soruyu çözebilmiş ve gümüş madalya seviyesinde kalmıştı. Üstelik bu sonucu 4,5 saat yerine 2-3 günlük hesaplamalarla elde etmişti.
IMO Başkanı Gregor Dolinar, bu yılki sonuçlarla ilgili yaptığı açıklamada yapay zekâların yalnızca sonuçları değil, çözüm yollarını da etkileyici şekilde açıklayabildiğini belirtti:
“Yapay zekânın çözüm yöntemleri birçok açıdan dikkat çekiciydi. Değerlendiriciler bu açıklamaları açık, net ve anlaşılır buldu.” – Gregor Dolinar
Kusursuzluk Hâlâ Gençlerde
Ancak Google ve OpenAI’nin hâlâ ulaşamadığı bir başarı var: Tam puan. Bu yıl beş genç yarışmacı tüm soruları doğru cevaplayarak 42 puanı elde etmeyi başardı. AI modelleri için bu hedef şimdilik uzak gibi duruyor.
Ayrıca, modellerin bu başarıyı nasıl elde ettikleri de net değil. Örneğin, kullanılan işlem gücü miktarı ya da hesaplamalar sırasında insan müdahalesi olup olmadığı açıklanmadı. Bu da başarıyı değerlendirirken dikkatli olunması gerektiğini gösteriyor.
Enerji ve Çevresel Maliyetler
Bir diğer önemli konu ise çevresel etki. Yapay zekâ sistemlerinin bu denli güçlü sonuçlar üretebilmesi için devasa veri merkezlerine ihtiyaç duyuluyor. Bu merkezler enerji tüketiminin yanı sıra büyük miktarda su da harcıyor. Google, OpenAI ve Microsoft gibi şirketler bu altyapılar için milyarlarca dolarlık yatırımlar yapıyor. Ancak bu yatırımların çevresel etkileri henüz tam anlamıyla denetlenebilmiş değil.
Öyle ki bazı tahminlere göre, AI endüstrisinin enerji tüketimi önümüzdeki yıllarda Arjantin kadar bir ülkenin enerji kullanımına yaklaşabilir. Bu da yapay zekânın geleceğiyle ilgili çözülmesi gereken başka bir büyük sorun anlamına geliyor.